Verbindingen naar een datacenter monitor je door continu de beschikbaarheid, latency, bandbreedte en pakketverlies van je netwerkverbindingen te meten en te analyseren. Dat doe je met een combinatie van actieve en passieve monitoringmethoden, ondersteund door gespecialiseerde tools die afwijkingen direct signaleren. In dit artikel beantwoorden we de meest gestelde vragen over het bewaken van datacenter-connectiviteit, van de juiste KPI’s tot wat je doet als er iets misgaat.
Welke verbindingstypen naar een datacenter zijn er te monitoren?
De meest voorkomende verbindingstypen naar een datacenter zijn glasvezelverbindingen (dedicated of gedeeld), MPLS-verbindingen, SD-WAN-verbindingen, internet-uplinks en directe cross-connects. Elk type heeft eigen monitoringvereisten, afhankelijk van de protocollen, de SLA-afspraken en de kritikaliteit van de verbinding voor je bedrijfsprocessen.
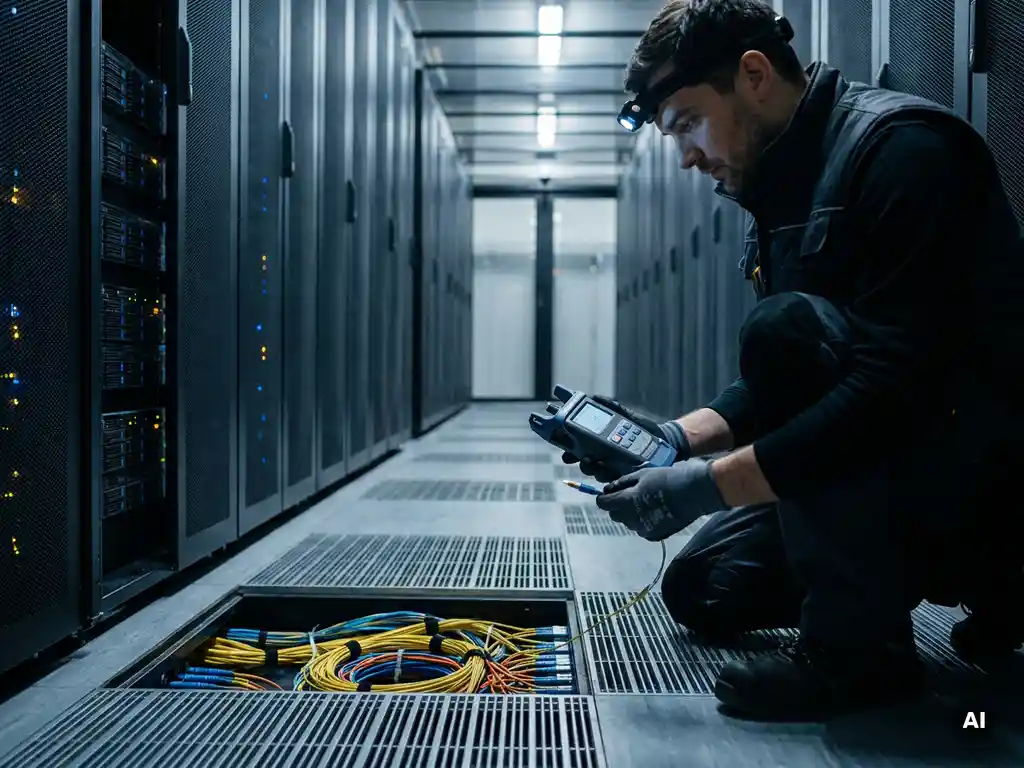
Bij glasvezelverbindingen gaat het om fysieke laag-1-monitoring: je wilt weten of het signaal stabiel is, of er optisch vermogensverlies optreedt en of de kabel fysiek intact is. Dit soort monitoring geeft je inzicht in degradatie voordat een verbinding volledig uitvalt. Voor optische verbindingen is dit een essentieel onderdeel van proactief beheer.
MPLS- en SD-WAN-verbindingen monitor je primair op laag 2 en 3: routingstabiliteit, QoS-parameters en end-to-end latency zijn hier de sleutelindicatoren. SD-WAN voegt daar nog de mogelijkheid aan toe om verbindingen dynamisch te bewaken en verkeer automatisch om te leiden bij degradatie.
Internet-uplinks vereisen monitoring op BGP-stabiliteit, routewijzigingen en bandbreedtegebruik. Cross-connects binnen een datacenter worden bewaakt op fysieke integriteit en poortstatus. Door elk verbindingstype apart te bewaken, voorkom je dat je een probleem op de verkeerde laag zoekt.
Welke KPI’s zijn het meest kritiek bij datacenter-connectiviteitsmonitoring?
De meest kritieke KPI’s voor het bewaken van datacenter-connectiviteit zijn beschikbaarheid (uptime), latency, jitter, pakketverlies en bandbreedtegebruik. Deze vijf metrics samen geven een volledig beeld van de gezondheid van je verbinding en vormen de basis voor zinvolle SLA-rapportages en capaciteitsplanning.
- Beschikbaarheid (uptime): het percentage van de tijd dat de verbinding operationeel is. Voor bedrijfskritische omgevingen is een target van 99,99% of hoger gebruikelijk.
- Latency: de vertraging waarmee datapakketten van bron naar bestemming reizen. Hoge latency heeft direct impact op applicatieprestaties, zeker bij realtime toepassingen zoals VoIP of databasetransacties.
- Jitter: de variatie in latency over tijd. Jitter is extra schadelijk voor tijdgevoelige applicaties en videoconferencing.
- Pakketverlies: het percentage datapakketten dat de bestemming niet bereikt. Zelfs een verlies van 0,1% kan merkbare prestatieproblemen veroorzaken in applicaties die TCP gebruiken.
- Bandbreedtegebruik: de verhouding tussen het werkelijke dataverkeer en de beschikbare capaciteit. Aanhoudend gebruik boven de 80% is een signaal dat je verbinding aan vervanging of uitbreiding toe is.
Naast deze vijf is het zinvol om ook BGP-stabiliteit te monitoren bij internetverbindingen en de optische signaalkwaliteit bij glasvezelverbindingen. Zo dek je zowel de logische als de fysieke laag af.
Hoe werkt actieve versus passieve netwerkmonitoring?
Actieve monitoring stuurt zelf testverkeer over de verbinding om prestaties te meten, terwijl passieve monitoring het bestaande verkeer analyseert zonder er zelf aan bij te dragen. Beide methoden vullen elkaar aan en samen geven ze een completer beeld dan elk afzonderlijk.
Actieve monitoring
Bij actieve monitoring genereer je bewust testpakketten, bijvoorbeeld via ICMP-pings, TCP-probes of gespecialiseerde protocollen zoals TWAMP of IP SLA. Je meet hiermee latency, jitter en pakketverlies op een gecontroleerde manier, ook op momenten dat er weinig productieverkeer is. Het nadeel is dat actieve monitoring zelf bandbreedte verbruikt en niet altijd representatief is voor het gedrag van echte applicaties.
Passieve monitoring
Passieve monitoring analyseert het werkelijke productieverkeer via technieken als NetFlow, sFlow of pakketopname. Je ziet precies hoe applicaties zich gedragen, welke flows de meeste bandbreedte verbruiken en waar congestie ontstaat. Het nadeel is dat je afhankelijk bent van daadwerkelijk verkeer: als er weinig data stroomt, zie je ook weinig. Bovendien vereist diepgaande pakketanalyse rekenkracht en opslag.
In de praktijk combineer je beide: actieve monitoring voor continue beschikbaarheidschecks en baseline-metingen, passieve monitoring voor inzicht in het werkelijke verkeersgedrag en probleemdiagnose.
Welke tools gebruik je voor het monitoren van datacenterverbindingen?
Voor het monitoren van datacenter-connectiviteit gebruik je een combinatie van netwerkmonitoringsplatforms, flowanalysetools en apparatuurspecifieke beheerinterfaces. De keuze hangt af van de schaal van je omgeving, de verbindingstypen en de gewenste mate van automatisering.
Een goed monitoringlandschap bestaat doorgaans uit drie lagen:
- Infrastructuurmonitoring: tools die de status van fysieke en logische apparatuur bewaken, zoals switches, routers en optische transceivers. Ze geven inzicht in poortstatus, optisch vermogen en apparaatgezondheid.
- Verkeersanalyse: flowgebaseerde tools die NetFlow- of sFlow-data verzamelen en visualiseren. Hiermee zie je welke applicaties en gebruikers bandbreedte verbruiken en waar knelpunten ontstaan.
- End-to-end prestatiemonitoring: actieve testoplossingen die de verbindingskwaliteit meten vanuit het perspectief van de gebruiker of applicatie, onafhankelijk van de onderliggende infrastructuur.
Specifiek voor glasvezelverbindingen zijn realtime glasvezelbewaking en OTDR-gebaseerde monitoring waardevolle aanvullingen. Ze detecteren fysieke degradatie, breukpunten of demping in de glasvezelkabel voordat die tot een storing leidt.
Voor omgevingen waar beheer op afstand noodzakelijk is, biedt out-of-band management een veilig alternatief kanaal om apparatuur te bereiken en te monitoren, ook als de primaire verbinding is uitgevallen.
Hoe stel je zinvolle alerts in voor datacenter-uptime?
Zinvolle alerts voor datacenter-uptime stel je in door drempelwaarden te baseren op gemeten baselines, niet op willekeurige standaardwaarden. Een alert is pas nuttig als hij een echte afwijking signaleert die actie vereist, zonder je team te overspoelen met valse meldingen die worden genegeerd.
Ga als volgt te werk:
- Meet je baseline: verzamel gedurende twee tot vier weken data over latency, pakketverlies en bandbreedtegebruik. Dit geeft je het normale gedrag van de verbinding.
- Stel dynamische drempelwaarden in: stel alerts in op afwijkingen ten opzichte van de baseline, niet op absolute getallen. Een latency van 10 ms is normaal voor de ene verbinding en alarmerend voor de andere.
- Gebruik meerdere ernstsniveaus: onderscheid tussen waarschuwingen (trend die aandacht verdient) en kritieke alerts (direct actie vereist). Dit helpt je team prioriteiten te stellen.
- Bouw tijdsvensters in: geef pas een alert als een drempelwaarde gedurende een bepaalde tijd wordt overschreden, niet bij één piekmoment. Dit filtert valse positieven eruit.
- Koppel alerts aan processen: een alert zonder duidelijk escalatiepad heeft weinig waarde. Zorg dat elke alert leidt tot een gedefinieerde actie of bij een verantwoordelijke terechtkomt.
Voor kritieke datacenterverbindingen is het ook verstandig om alerts te configureren op optische signaaldegradatie, BGP-routewijzigingen en SLA-grenswaarden. Zo ondervang je problemen voordat ze zichtbaar worden voor eindgebruikers.
Wat doe je als een datacenterverbinding uitvalt of degradeert?
Als een datacenterverbinding uitvalt of degradeert, volg je een gestructureerd herstelproces: eerst isoleer je het probleem op de juiste OSI-laag, dan activeer je eventuele failover-mechanismen en vervolgens herstel je de primaire verbinding met minimale impact op de bedrijfsvoering. Voorbereiding is hierbij doorslaggevend.
Directe stappen bij een storing
Controleer eerst of het probleem zich voordoet op de fysieke laag (kabelbreuk, optisch vermogensverlies, apparaatfout), de logische laag (routingprobleem, configuratiefout) of bij de provider (netwerkstoringen buiten jouw beheer). Gebruik je monitoringtools om de scope te bepalen: is het één verbinding, één locatie of een breder probleem?
Activeer daarna je failover-configuratie als die beschikbaar is. SD-WAN-omgevingen doen dit automatisch; bij traditionele WAN-verbindingen kan een back-upverbinding handmatig of via scripts worden geactiveerd. Communiceer intern over de status en verwachte hersteltijd.
Herstel en nazorg
Na herstel van de primaire verbinding analyseer je de oorzaak grondig. Wat veroorzaakte de storing? Was het te voorzien op basis van monitoringdata? Had een alert eerder kunnen waarschuwen? Deze vragen leiden tot verbeteringen in je monitoringconfiguratie en eventueel in de redundantie van je infrastructuur.
Voor omgevingen waar continue beschikbaarheid niet onderhandelbaar is, zoals ziekenhuizen, datacenters of kritieke infrastructuur, is een robuuste netwerkarchitectuur met ingebouwde redundantie de meest effectieve bescherming tegen uitval. Monitoring vertelt je wanneer iets misgaat; de architectuur bepaalt hoe snel je herstelt.
Wil je weten hoe je jouw datacenter-connectiviteit structureel beter kunt bewaken en beveiligen? Onze engineers denken graag met je mee over een aanpak die past bij jouw omgeving en risiconiveau.
Klaar voor de volgende stap?
Bekijk onze oplossingen of neem direct contact op met een van onze experts.